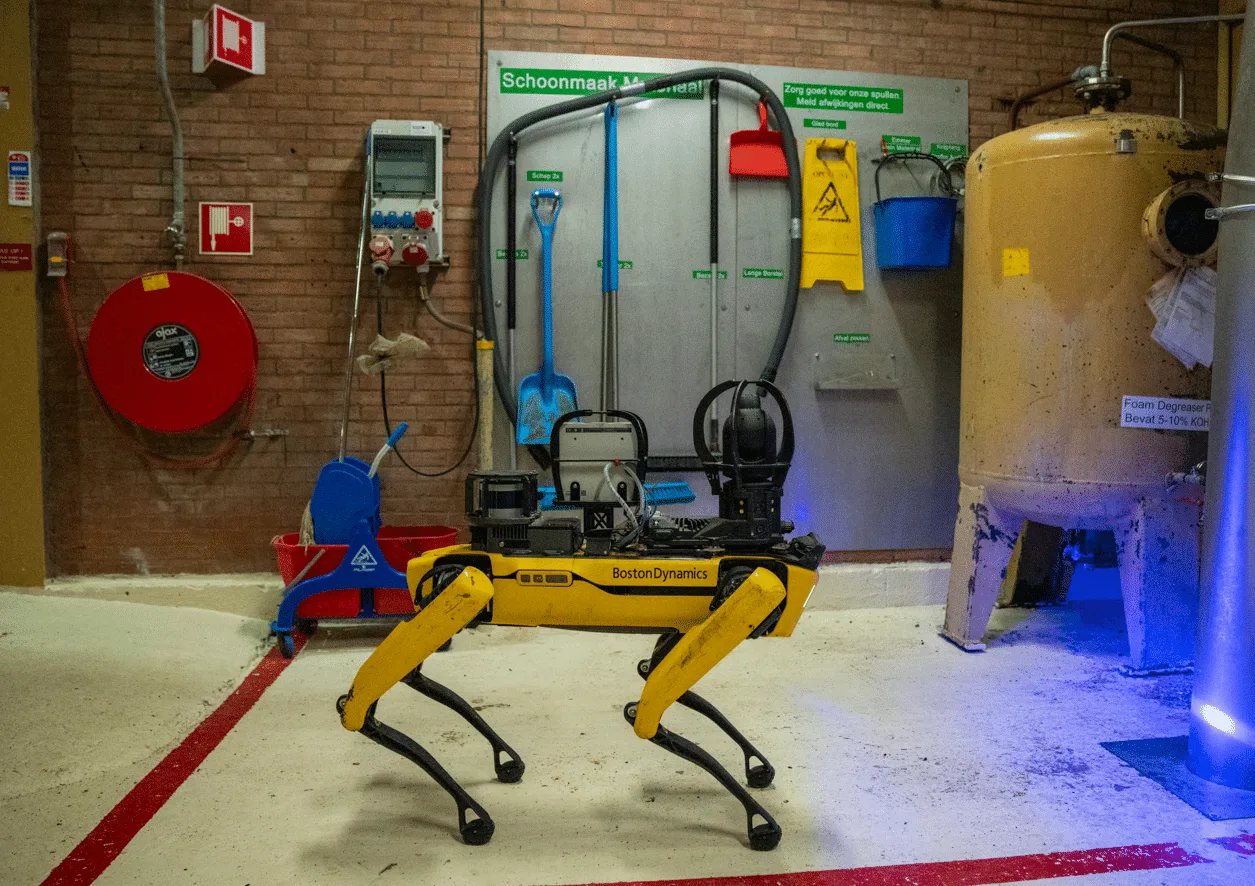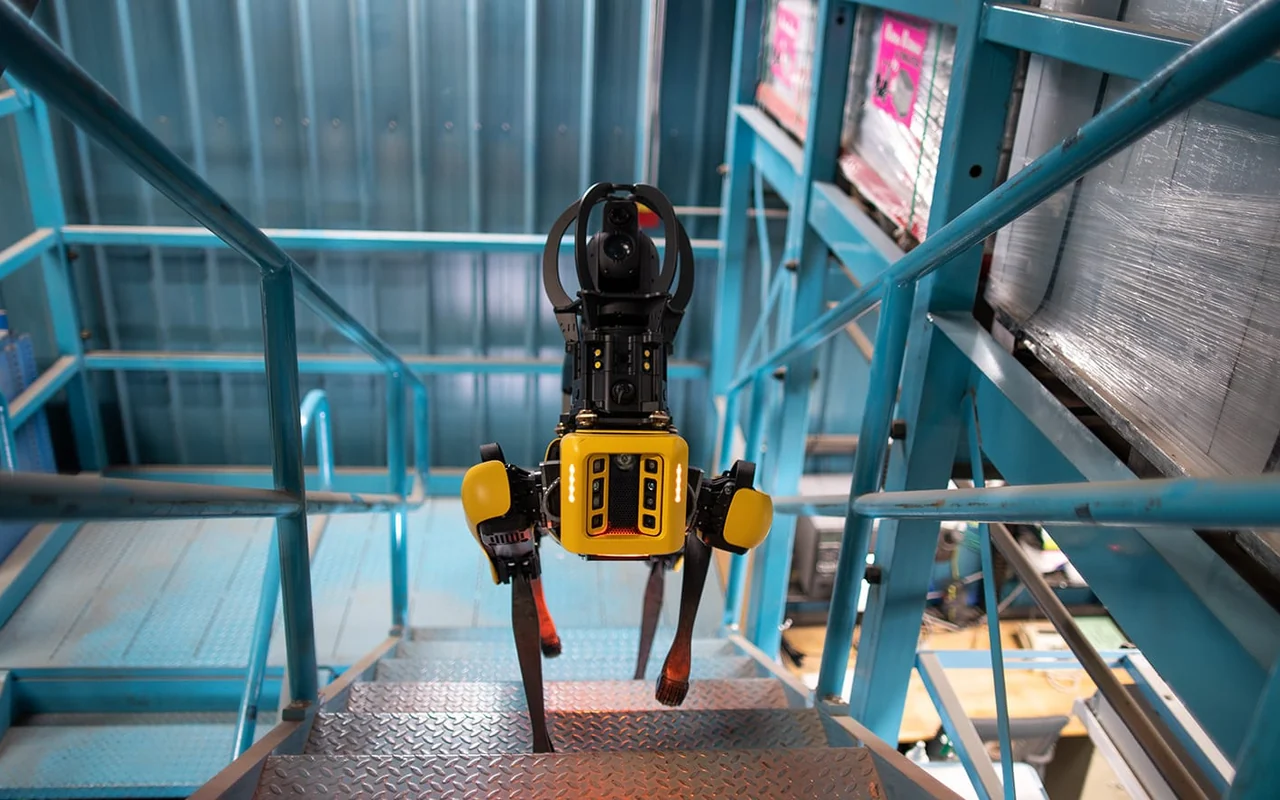
Boston Dynamics携手Google Cloud与Google DeepMind,将Gemini与Gemini Robotics-ER 1.6模型集成进AIVI-Learning——Orbit平台的视觉巡检模块,管理Spot机器人。DeepMind于2026年4月14日发布新模型,Boston Dynamics客户自4月8日起可用AIVI-Learning。
Gemini Robotics-ER是一款“具身推理”模型:负责空间理解、任务规划与结果验证。必要时模型可自动调用工具——如Google搜索、视觉-语言-动作模型或用户自定义功能。
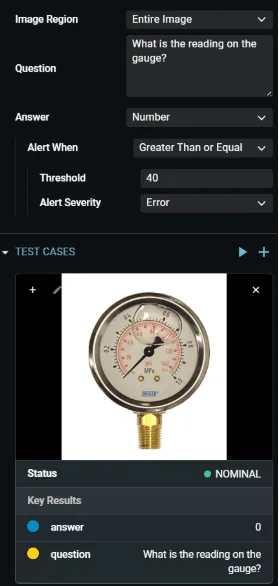
最大亮点是仪表读数功能,由DeepMind与Boston Dynamics联合开发。Spot巡视现场,拍摄压力表、液位计和数字面板,模型自动识别读数。其方法为放大图片片段,标记指针与刻度,代码计算比例,并识别单位,精度可达小于一格。
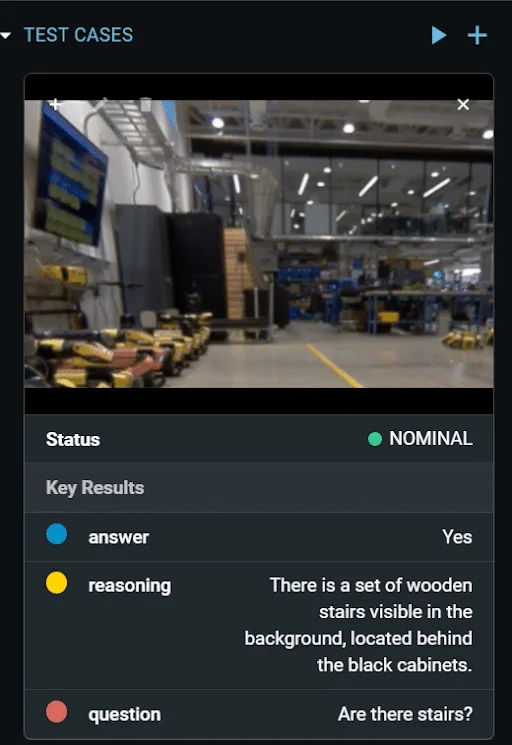
实际应用包括:安全巡检(查找危险杂物与泄漏)、输送带损伤检测、视窗液位0–100%检查、托盘计数及5S秩序审核。模型答复中可见推理链路,更新通过云端实时推送,无需停机。使用AIVI-Learning需客户同意数据用于模型训练。
Boston Dynamics下一步将实现水渍与陌生人实时地图警报。对工业巡检客户而言,新增检查类型只需配置请求,无需单独开发。需注意功能依赖云端服务器,需与厂商数据交互。